Alibaba Cloud ECS について”StoragePerformanceReachLimit:Executed”のアラートが Cloud Monitor から届いたので調査と対処を記録する。
結論、一時的なストレージIOの消費が高まったためのアラート。 その時にどんな処理をしていたかはその時じゃないとわからないこともあるので再発、再現を待つことにします。 その結果次第では Cloud Storage の性能アップのための構成変更を考えます。
目次
Qwen でトラブルシューティングする
とりあえず、このメッセージが示すものを調べる。 調べ方は色々あるが、まずは Alibaba Cloud Model Studio の Qwen に聞いてみる。 なお、Alibaba Cloudのトラブルシューティングはこのように生成AIに相談するよりも Alibaba Cloud コンソール所のAssistant AI に聞いた方が話は早い。 Assistant AIを利用したトラブルシューティングは次のセクションで紹介します。
「私が利用している Alibaba Cloud のECSについて、StoragePerformanceReachLimit:Executedのアラートを受け取った これはどんな問題がおきているのか、どんな対処が必要か?」
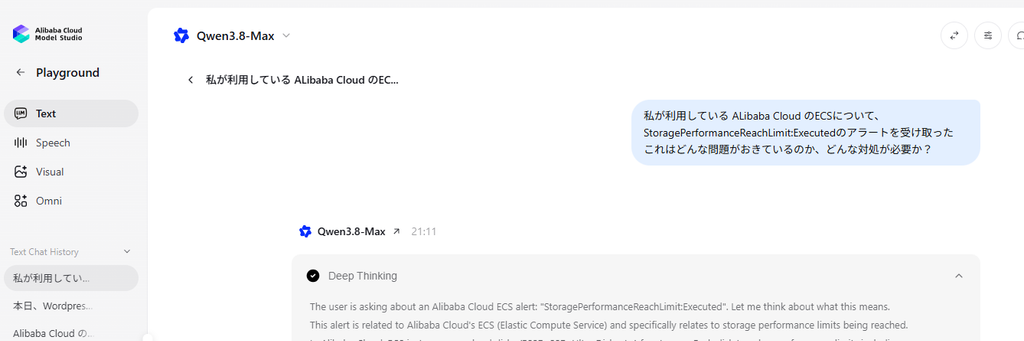
一回の問い合わせで以下紹介する内容、原因の説明から現状調査方法、4つの解消策まで一回で回答が来ます。
また、消費したトークンは以下の通り。 Input で86、Output で 1,320 の消費でした。
このアラートは、ECSインスタンスにアタッチされているクラウドディスクの性能上限(IOPS またはスループット)に達したことを示すシステムイベントです。
具体的には:
Table
| 項目 | 説明 |
|---|---|
| IOPS上限到達 | ディスクが処理できるI/O操作数が上限に達し、それ以上のリクエストがキューイング/スロットリングされている |
| スループット上限到達 | ディスクの読み書き速度(MB/s)が上限に達している |
- ⚠️ I/Oレイテンシの増大
- ⚠️ アプリケーションの応答遅延
- ⚠️ データベースのクエリ遅延・タイムアウト
- ⚠️ 最悪の場合、サービスの可用性低下
まず、どのディスクがボトルネックになっているか確認します:
# CloudMonitor でディスクごとのメトリクスを確認
# 対象メトリクス:
# - DiskReadIOPS / DiskWriteIOPS
# - DiskReadBPS / DiskWriteBPS
また、インスタンス内で確認:
# I/O状況の確認
iostat -x 1 5

# 高いI/Oを発生させているプロセスの特定
iotop -oP
Table
| ディスク種別 | 最大IOPS | 最大スループット |
|---|---|---|
| Ultra Disk | 5,000 | 140 MB/s |
| SSD Cloud Disk | 25,000 | 300 MB/s |
| ESSD PL0 | 10,000 | 180 MB/s |
| ESSD PL1 | 50,000 | 350 MB/s |
| ESSD PL2 | 100,000 | 750 MB/s |
| ESSD PL3 | 1,000,000 | 4,000 MB/s |
コンソール → ECS → ディスク → ディスクカテゴリの変更 からオンラインで変更可能です(ダウンタイム不要)。
同じカテゴリでも、ディスク容量が大きいほどIOPS/スループット上限が上がります。
例:ESSD PL1 の場合
最大IOPS = min{1800 + 50 × 容量(GB), 50000}
最大スループット = min{120 + 0.5 × 容量(GB), 350} MB/s
- データベースの不要なクエリ・フルスキャンの排除
- キャッシュの活用(Redis等)でディスクI/O自体を減らす
- ログ出力量の削減
データディスクを追加し、I/Oを分散させる方法もあります。
推奨アクション(優先順)
① iostat / CloudMonitor でボトルネックのディスクを特定
② 一時的なスパイクか、恒常的な上限到達か判断
③ 恒常的 → ディスクカテゴリのアップグレード or サイズ拡大
   一時的 → アプリケーション側の最適化を検討
補足:アラートの再発防止
CloudMonitor で以下のしきい値アラートを設定しておくと、上限到達前に気づけます:
- DiskIOPSUtilization ≥ 80% で警告
- DiskBPSUtilization ≥ 80% で警告
AI Assistant を利用したトラブルシューティング
Alibaba Cloud のリソースに関するトラブルシューティングや技術調査は AI Assistant を利用するのが最もシンプルで効果的です。 なぜなら実際のリソースの状態を把握しながら調査や対処を行ってくれるからです。
AI Assistant は Alibaba Cloud コンソールの上のメニューから起動します。
AI Assistant が起動します(ポップアップウィンドウ)。
何回か問答して得られた回答は以下。 Qwenに聞いたのと大体同じ内容でした。 instance ID なども与えたので原因究明までやってくれることを期待したのですが今回は無理でした。
The StoragePerformanceReachLimit:Executed event with reasonCode: EcsBaseBPS for instance i-9999999qje3u2hgp5z66 indicates that the disk bandwidth of this ECS instance has reached the baseline limit defined for its instance type
. This is a performance throttling event triggered when storage performance hits the instance type limit twice within three minutes, and sustained throttling may degrade business I/O operations
.
- Verify Instance Specifications: Check the current instance type’s baseline storage bandwidth limit in the ECS console or the Overview of instance families documentation to confirm the exact threshold being hit.
- Analyze Disk I/O Usage: Identify processes causing high disk bandwidth consumption by referring to the troubleshooting guides for Linux systems or Windows systems.
- Upgrade Instance Type: If the workload consistently requires higher disk bandwidth, upgrade to an instance type with a higher baseline storage bandwidth specification; note that effective performance is capped at whichever is lower between the instance type limit and the attached cloud disks’ total capacity.
- Optimize Application I/O: Reduce disk bandwidth demand by optimizing application read/write patterns or implementing caching mechanisms to stay within the current instance type’s baseline limits.
以上