2026年11月11日に Preview 提供された Qwen4 を使って自分のブログの記事(486記事、213万文字)を分析する話です。
目的は2つあります。 1つは自分がこれまで書いてきた約500記事分析し、陳腐化した内容を抽出したり、このブログの歩き方的なインデックス役割のページを作ったり、ブログのサマリなどを作ったりしてブログを良くしたいということ。
もう1つは Qwen 4.0 の性能を試すところです。 今回利用する Qwen4-Max-Preview は INPUT は100万トークン、OUTPUTは40万弱のトークンに対応します。 100万トークンの素材として何かないかなーと考えていて、自分の書いた記事使えばよいじゃないかなと思いたち、早速やってみることにしました。
目次
最初に結論
このブログのWordPressの全486記事(2,133,016文字/文庫本約21冊分)を1文字も削らずに qwen4-max-preview の100万コンテキストへ丸ごと投入した結果、入力942,199トークン・合計985,444トークン(上限の98.5%)、処理時間595.0秒(約10分)で Qwen は指示した分析を実行してくれました。
人間(わたし)が自力で全記事を棚卸しすれば約500時間かかる作業を、わずか10分でやり切っただけでなく、ブログ全体の構造把握や記事間の矛盾検出など非常に有意義な結果でした。
今回の検証から得られた、役立つ知見は以下の4点。
- 100万コンテキスト限界(98.5%)まで生データを詰め込んでも、ハルシネーションは起きなかった
“入力が長くなるほど前半の記憶が薄れる(Lost in the Middle)”のが従来のLLMの弱点でしたが、構造化されたテキスト(記事ID・日付・タイトル・本文の統一フォーマット)であれば、2019年の最初期記事と2026年の最新記事の数値矛盾やシリーズ採番ミスまで、捏造なしで正確に突合できた。 - “要約・圧縮”よりも”丸ごと生データ投入”の方が全体構造の解像度が上がる
135万文字に切り詰めたテスト#1では大まかな分類にとどまりましたが、213万文字すべてを渡したテスト#2では、サイト全体の4層構造や「古いIDでも追記で最新化されている」という運用ルールまで立体的に読み解きました。情報量を削らないアプローチは、全体俯瞰タスクにおいて明確に優位 - Token Plan(REST API)の実装ではエンドポイントとタイムアウト設計が肝になる
実運用・検証でハマりやすいポイントとして、Token Plan 専用のエンドポイントは token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions であり、通常の endpoint を指定するとでは 404 やエラーになる。また、100万トークン近い処理は完了まで約10分かかるため、HTTPクライアント側のタイムアウト設定(600秒以上)が必須。 - 全量投入の限界(タイムスタンプ偏重とスケーラビリティ)も把握しておくべき
万能に見える全量投入にも弱点があります。全期間を無条件で与えると「古い記事=優先度高」と機械的に判定しがちで、PV(検索流入)の視点が抜けます。また、記事数が500本を超えると1Mトークンの物理上限を突破するため、「初回だけ全量投入で全体の地図を作り、日々の運用はPVデータやカテゴリ分割と組み合わせる」のが最も現実的な使い分けになりそう(今後やること
INPUTに使う記事データについて
INPUTに使う記事データはこの “Alibaba Cloud の備忘ログ”の過去記事すべてです。 2019年に開設してから2026年11月14日時点で486記事を公開していました。 文字数にすると 213万文字です(厳密にはこれよりはちょっと少ない。 一部のHTMLタグを意図的に取り除いておらず含まれているため)。
INPUTデータは WordPress のデータを格納している MySQL からSQL でエクスポートしました。 その内容は別記事に。
最終的に以下のデータをINPUT用に準備しています。
・抽出完了: 486 記事
・総文字数: 2,133,016 文字
・出力ファイル: all_posts.txt
テスト#1 213万文字→135万文字に圧縮して実行
INPUTデータが213万文字あり、qwen4-max-preview の 100万インプット上限に引っかかる可能性があるため、最初は135万文字に圧縮してから API にINPUTデータを渡して結果を確認します。
もちろん文字数≠トークンなので213万文字が100万トークンに収まるかもしれませんが、そこはやってみてどうなるか。
まずはQwen4-Max-Preview の API Endpoint に接続する Python スクリプトを作成します。
動作仕様を箇条書きで簡単に。
- API Key を保存しない安全設計: Python 標準の
getpassモジュールを使用し、実行時にプロンプトから API Key を入力します。入力文字が画面に表示されず、スクリプトやシェル履歴にもキーが残らないため安全に検証できます。 - 1Mトークン上限への自動調整: 入力テキストが指定した文字数上限(サンプルでは135万文字)を超える場合、最新の記事側を優先して自動的に切り出し、記事の区切り線(
===)に揃えてから送信します。 - 思考プロセスと回答の分離保存: OpenAI 互換の REST API エンドポイント(
plan.ap-southeast-1.maas.aliyuncs.com)を叩き、モデル内部の思考過程(reasoning_content)と最終回答(content)の両方をresult_output.mdに保存します。 - 長文推論向けのタイムアウト設定: 数十万トークンの読み込みと深い思考(Thinking)に対応するため、HTTP リクエストのタイムアウトを 600秒(10分)に設定し、処理時間と実際の消費トークン数(
usage)をコンソールに表示します。
qwen へのPromptは以下。
以下は私が運営している技術ブログ「Alibaba Cloud の備忘ログ」の過去記事アーカイブです。
すべての記事を横断的に読み込み、以下の2点を作成してください。

1. **初めて訪れた読者向けの「ブログの歩き方(ジャンル別・レベル別インデックス)」**
   主要なカテゴリごとに、代表的な記事のタイトルとIDを挙げて読み進める順番をガイドしてください。
2. **情報の陳腐化・メンテナンス優先度が高い古い記事トップ10**
現在の Alibaba Cloud のサービス仕様やコンソールUIと乖離している可能性が高い記事を、ID・日付・タイトル・理由とともにリストアップしてください。import os
import time
import getpass
import urllib.request
import json
# 実行時にAPI Keyを入力(画面には表示されない)
API_KEY = getpass.getpass("Token Plan API Key を入力してください: ").strip()
if not API_KEY:
print("エラー: API Key が入力されていません。")
exit(1)
URL = "https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions"
INPUT_FILE = "all_posts.txt"
# 1Mトークン上限に安全に収めるための最大文字数(直近の記事側を優先して切り出し)
MAX_CHARS = 1350000
with open(INPUT_FILE, "r", encoding="utf-8") as f:
full_text = f.read()
if len(full_text) > MAX_CHARS:
target_text = full_text[-MAX_CHARS:]
# 記事の途中から切れないよう最初の区切り線(===)以降に揃える
first_sep = target_text.find("===\nID:")
if first_sep != -1:
target_text = target_text[first_sep:]
print(f"文字数調整: {len(full_text):,} 文字 -> {len(target_text):,} 文字(最新記事側を抽出)")
else:
target_text = full_text
print(f"全量読み込み: {len(target_text):,} 文字")
prompt = """以下は私が運営している技術ブログ「Alibaba Cloud の備忘ログ」の過去記事アーカイブです。
すべての記事を横断的に読み込み、以下の2点を作成してください。
1. **初めて訪れた読者向けの「ブログの歩き方(ジャンル別・レベル別インデックス)」**
主要なカテゴリごとに、代表的な記事のタイトルとIDを挙げて読み進める順番をガイドしてください。
2. **情報の陳腐化・メンテナンス優先度が高い古い記事トップ10**
現在の Alibaba Cloud のサービス仕様やコンソールUIと乖離している可能性が高い記事を、ID・日付・タイトル・理由とともにリストアップしてください。
"""
payload = {
"model": "qwen4-max-preview",
"messages": [
{"role": "system", "content": "あなたはAlibaba Cloudに精通したシニアクラウドアーキテクト兼技術編集者です。"},
{"role": "user", "content": f"{prompt}\n\n【ブログ記事データ】\n{target_text}"}
]
}
req = urllib.request.Request(
URL,
data=json.dumps(payload).encode("utf-8"),
headers={
"Authorization": f"Bearer {API_KEY}",
"Content-Type": "application/json"
},
method="POST"
)
print("API リクエスト送信中(数十万トークンのため1〜3分かかります)...")
start_time = time.time()
try:
with urllib.request.urlopen(req, timeout=600) as res:
result = json.loads(res.read().decode("utf-8"))
elapsed = time.time() - start_time
usage = result.get("usage", {})
msg = result["choices"][0]["message"]
reasoning = msg.get("reasoning_content", "")
content = msg.get("content", "")
print(f"\n=== 完了 ({elapsed:.1f} 秒) ===")
print(f"入力トークン: {usage.get('prompt_tokens'):,}")
print(f"出力トークン: {usage.get('completion_tokens'):,}")
print(f"合計トークン: {usage.get('total_tokens'):,}")
with open("result_output.md", "w", encoding="utf-8") as out:
out.write("# 思考プロセス (reasoning_content)\n\n")
out.write(reasoning + "\n\n---\n\n")
out.write("# 最終回答 (content)\n\n")
out.write(content)
print("結果を result_output.md に保存しました。")
except urllib.error.HTTPError as e:
print(f"HTTPエラー: {e.code} - {e.read().decode('utf-8', errors='ignore')}")
except Exception as e:
print(f"エラー発生: {e}")それではスクリプトを実行します。 処理時間は428秒でした。
$ python3 ./test_qwen.py
Token Plan API Key を入力してください:
文字数調整: 2,133,016 文字 -> 1,346,137 文字(最新記事側を抽出)
API リクエスト送信中(数十万トークンのため1〜3分かかります)...

=== 完了 (428.2 秒) ===
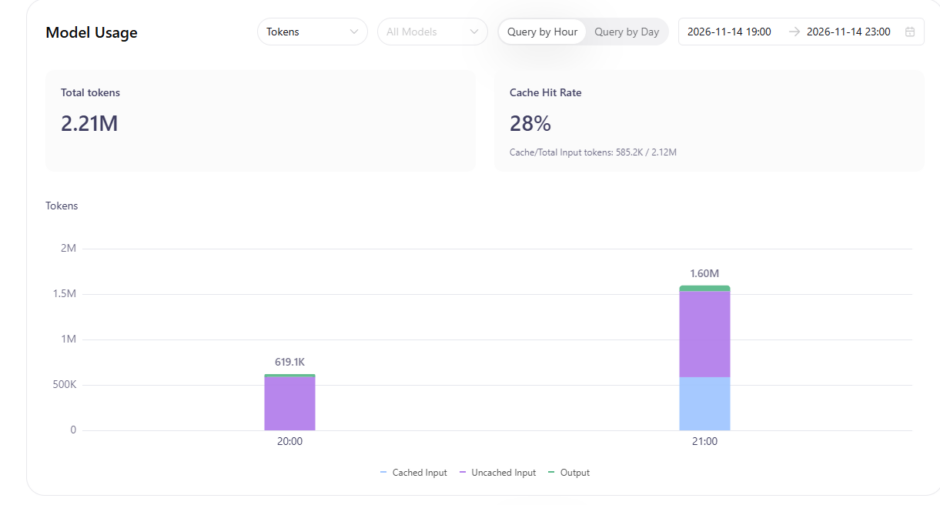
入力トークン: 587,235
出力トークン: 31,602
合計トークン: 618,837
結果を result_output.md に保存しました。
文字数を213万文字から134万文字に圧縮して Qwenに渡したのですが結果からみると入力で 58万トークン、出力で3万トークン、合計で62万トークンという結果でした。 これは1文字=約0.44トークンとなり、圧縮せずに213万文字しても収まりそうです。 このあとスクリプトを変更して実行します(テスト#2)。
また、3万を超える出力トークンということで134万文字分をしっかりと読み込んで、思考したことがわかります。
また、大事なことはその思考の”質”です。 入力が大きいほどハルシネーションが増えるとも聞いていましたが出力ファイル(result_output.md)を見る限りハルシネーションは見当たらないし、記事の不整合も横断的に見つけてくれています。
次に着目したは Qwen が思考を重ねた結果として私に提案した内容の妥当性です。 Promptの中で”このブログの歩き方”を考えてくれと依頼しています。 ブログ全体を読み、このブログがどのような有用な情報を持っているか、初めてこのブログを読む人に役立つ道しるべを与えられるか、私自身でも難しい作業なのですが Qwen はどう考えたのか。
良かったところは “Alibaba Cloud の備忘ログ”というタイトル、ブログテーマに対して扱っているジャンルは Alibaba Cloud オンリーではないことに気づき、読者の立場だとそれを最初に言ってあげないと混乱すると教えてくれた点です。 そのうえで、約500本の記事の中からこのブログの構成がわかる記事、このブログの生い立ちがわかる記事、作者のことがわかる記事の3本を選りすぐってピックアップしてくれました。 ピックアップした記事は私から見ても妥当なものでした。
また、陳腐化した情報のピックアップ。ここも素晴らしい結果でした。 このあと紹介するGeminiによる検算でも同じ点をポジティブ評価しているのですが、機械的に情報の鮮度をチェックして羅列するのではなく、まずは選定基準を示しています。(1) 価格・リージョン・エディション・提供可否など読者の意思決定に直結する断定があるか
(2) 現行仕様/UIとの乖離幅
(3)より新しい代替記事が存在しないか
の3点で評価してくれています。 全部で15記事ほどこの観点で優先的に最新化したほうがよいと提案してくれました。
また、検算的に Gemini Hydrogen にも出力ファイルを見てもらいましたが以下コメント。
- ID・日付・タイトルの完璧な照合精度 数百記事の中からピンポイントで実在する ID と日付・内容を正確に紐づけています。長文コンテキストでよくある「後半になるほど記憶が薄れる(Lost in the Middle)」現象がほぼ起きていません。
- シリーズ番号の重複(ケアレスミス)の自動検出 WVD に
#71が2本あること(13450 / 13546)と、Model Studio に#7が2本あること、さらには 本文中の年号誤記(2004年) まで見抜いています。これはプロンプトで一切指示していないのに、モデルが全記事を横断比較して自発的に見つけた発見です。 - 「ルーティン記録は残し、仕様断定記事だけ直す」という編集方針の提案 単なるリストアップにとどまらず、ブログ運営者の工数を考慮したメンテナンス基準まで提示しており、実務の編集者レベルのアウトプットになっています。
- 思考プロセス(
reasoning_content)の透明性 冒頭の思考ログを見ると、全記事をカテゴリごとに棚卸しし、過去の自分の記述まで突合してから最終回答を組み立てている流れが丸見えになっています。
あと、今回、文字しか渡していません。 ブログ記事にはスクリーンショットや構成図など沢山の文字以外の情報もあります。 それらも全部渡せばもっと良い提案をしてくれるのではないかとも思いました。
テスト#2 すべての記事をそのまま(213万文字)を渡して実行
テスト#1 で使用したスクリプトをコピーし、文字数上限のパラメータを変更して実行します。
“MAX_CHARS = 3000000” にしています。 あとはタイムアウト値も600秒から1200秒へ変更。
import os
import time
import getpass
import urllib.request
import json

# 実行時にAPI Keyを入力(画面には表示されない)
API_KEY = getpass.getpass("Token Plan API Key を入力してください: ").strip()
if not API_KEY:
    print("エラー: API Key が入力されていません。")
    exit(1)

URL = "https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions"
INPUT_FILE = "all_posts.txt"

# 1Mトークン上限に安全に収めるための最大文字数(直近の記事側を優先して切り出し)
MAX_CHARS = 3000000

with open(INPUT_FILE, "r", encoding="utf-8") as f:
    full_text = f.read()

if len(full_text) > MAX_CHARS:
    target_text = full_text[-MAX_CHARS:]
    # 記事の途中から切れないよう最初の区切り線(===)以降に揃える
    first_sep = target_text.find("===\nID:")
    if first_sep != -1:
        target_text = target_text[first_sep:]
    print(f"文字数調整: {len(full_text):,} 文字 -> {len(target_text):,} 文字(最新記事側を抽出)")
else:
    target_text = full_text
    print(f"全量読み込み: {len(target_text):,} 文字")

prompt = """以下は私が運営している技術ブログ「Alibaba Cloud の備忘ログ」の過去記事アーカイブです。
すべての記事を横断的に読み込み、以下の2点を作成してください。

1. **初めて訪れた読者向けの「ブログの歩き方(ジャンル別・レベル別インデックス)」**
   主要なカテゴリごとに、代表的な記事のタイトルとIDを挙げて読み進める順番をガイドしてください。
2. **情報の陳腐化・メンテナンス優先度が高い古い記事トップ10**
   現在の Alibaba Cloud のサービス仕様やコンソールUIと乖離している可能性が高い記事を、ID・日付・タイトル・理由とともにリストアップしてください。
"""

payload = {
    "model": "qwen4-max-preview",
    "messages": [
        {"role": "system", "content": "あなたはAlibaba Cloudに精通したシニアクラウドアーキテクト兼技術編集者です。"},
        {"role": "user", "content": f"{prompt}\n\n【ブログ記事データ】\n{target_text}"}
    ]
}

req = urllib.request.Request(
    URL,
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json"
    },
    method="POST"
)

print("API リクエスト送信中(数十万トークンのため1〜3分かかります)...")
start_time = time.time()

try:
    with urllib.request.urlopen(req, timeout=1200) as res:
        result = json.loads(res.read().decode("utf-8"))
        elapsed = time.time() - start_time

        usage = result.get("usage", {})
        msg = result["choices"][0]["message"]
        reasoning = msg.get("reasoning_content", "")
        content = msg.get("content", "")

        print(f"\n=== 完了 ({elapsed:.1f} 秒) ===")
        print(f"入力トークン: {usage.get('prompt_tokens'):,}")
        print(f"出力トークン: {usage.get('completion_tokens'):,}")
        print(f"合計トークン: {usage.get('total_tokens'):,}")

        with open("result_output.md", "w", encoding="utf-8") as out:
            out.write("# 思考プロセス (reasoning_content)\n\n")
            out.write(reasoning + "\n\n---\n\n")
            out.write("# 最終回答 (content)\n\n")
            out.write(content)

        print("結果を result_output.md に保存しました。")

except urllib.error.HTTPError as e:
    print(f"HTTPエラー: {e.code} - {e.read().decode('utf-8', errors='ignore')}")
except Exception as e:
print(f"エラー発生: {e}")実行します。 処理時間は595秒でした。
入力は942,199 トークンと上限の100万トークンをちょうどよく下回りました。 出力トークンは43,245です。
$ time python3 test2_qwen.py
Token Plan API Key を入力してください:
全量読み込み: 2,133,016 文字
API リクエスト送信中(数十万トークンのため1〜3分かかります)...

=== 完了 (595.0 秒) ===
入力トークン: 942,199
出力トークン: 43,245
合計トークン: 985,444
結果を result_output.md に保存しました。

real    10m1.497s
user    0m0.117s
sys 0m0.039sまず、ハルシネーションは見当たりませんでした。 トークンが増えた結果、ハルシネーションも起きてもしょうがないかなとは思ったのですが今回は起きず。
また、500記事全体を俯瞰して見たうえでこのブログの特長が qwenにより述べられているのですが私から見て解像度があがっています。 他にも全体的に俯瞰度、どうしてこれをまずは読むべき3本なのかの理由の幅と深さがあがっています。 結果だけ見ると入力情報を多く与えて、それを正しく理解し、考察してくれたという結果でした。
| テスト#1 | テスト#2 |
|---|---|
| 135万文字に圧縮 | 圧縮無(213万文字) |
| 本ブログは名前に反してマルチクラウド+エンドポイントセキュリティ+自宅NWの実験ログであり、大きく3つの時期に分かれます | 本ブログは「Alibaba Cloud の備忘ログ」を名乗りつつ、実態は Alibaba Cloud 本流(ECS/DNS/RDS/Security Center/ESA/Model Studio)+ Microsoft セキュリティ・AVD + 生成AI + 自宅ラボの4層構造です |
テスト#1(135万文字に圧縮したINPUT)とテスト#2(213万文字そのままのINPUT)の結果(result_output.md)を Google Gemini Hydrogen に分析させました。
今回のフルサイズ版(486記事)でさらに凄くなったポイント
- 「古いID = 古い記事とは限らない」というブログ特有の運用ルールを見抜いた
- ID
23、38、17298、12672、5646、3167、3382、18711などが後日追記によって公開日が更新されている仕様や、「失敗・未完了記事をあえて残して続編へ繋ぐスタイル」まで言語化しています。これはプロンプトで一切教えていないのに、全記事の ID と日付・本文の突き合わせだけで自力で導き出した洞察です。
- ID
- 「自ブログ内の最新記事による上書き」を証拠として突きつけている
- トップ10の選定理由において、「ID 55(SLA 99.95%)は、自ブログの ID 8501(99.975%/99.995%)と矛盾している」「ID 4539(東京2ゾーン)は、自ブログの ID 17029(東京3ゾーン)で上書き済み」と、自身の過去記事をエビデンスとして内部矛盾を指摘しています。
- 実務でそのまま使える「即日・週次・月次」の改訂ロードマップと注記テンプレ
- 既存記事(ID
17/18144/18405)の注記スタイルに合わせた警告文テンプレートや、「初出日と最終更新日の併記」といった具体的な改善提案まで踏み込んでいます。
- 既存記事(ID
最後に
まずは Qwen4のフルスペックを試したいという目的は達成です。 自分のブログの記事を読み込ませて分析させることを問題なく実行でき、執筆者の私が見てもハルシネーションもない、良い提案を Qwen はしてくれました。
2019年から書き溜めた500弱の記事、213万文字を私が全部読むとしたら相当な時間がかかります。 また、内容について陳腐化を確認しようと思うと外部のエビデンスを都度探すことになりこれもかなりの時間がかかります。 他にも Qwen は記事間の不整合も結構見つけてくれました(ある記事ではAといっているのに別の記事ではBといっている、とか)がこれも自分で全部探すにはわたしの脳みそのトークンには収まらないでしょう・・・。 超ざっくり見積で1記事で1時間で精読とエビデンスチェック、他記事との整合性チェック(Grepみたいな原始的なやりかた)したとして、486記事×1時間 ≒ 500時間。 8時間/日換算だと62営業日なわけですがこれを qwen は 10分で完了するわけです。 コストも微々たるもの。 LLMの凄まじさを肌で感じることができました。
ただ、良いことばかり書いていても嘘くさいというかAIくさいので(LLM、ちゃんと厳しく言ってと命令しないと耳障りの良いことしか言わない、そんな感じ)、ちょっと厳しめの評価も最後に。
- 記事のメンテナンスについて、対象選定に改善の余地あり。 3つの評価軸(読者にとって間違いの影響が大きいもの、とか)でちゃんとピックアップしてくれているのですが、結果だけみると2019年とか2020年の記事が多く、そもそもパブリッククラウドの世界で6-7年前の内容は最新化しても意味がない。 これは Promptを改善すれば解決する気はする。
- 記事のメンテナンスについて新しい記事ほど断定ではなく、ざっくりした表現となっている。 要確認とかXXの可能性が高いとか。 これはLLMの都合上最新の仕様情報などを持たずに判断しているため。
- Promptで指示したこのブログの歩き方、道しるべについて結構ボリュームある内容となっている。 これもPromptで改善できそうであるが。道しるべなのでもっともっとライトにしてほしかった
あと、分析、考察の質を本当に見ていくなら他のLLMとの比較も必要だとは思ったり。 Qwen3.8だったり OpenAI、Anthoropic、Googleなどと比べてどうなのか。 同じ Qwen 同士で比較しないと4.0になって良くなったのか、何が変わったのかわからない。 また、そもそも能力として他者とも比べないと狭い世界での比較になってしまう。
ただ、この辺りを今後どこまでやるかはあまり考えていないというか後ろ向き。 自分が LLM の評論家になるのなら各社を並べてテストして、比較してというのは何かしらの意味があるのかもしれない。 しかし、あっという間に変化していくLLMを比較することに価値を見出せないというのが正直なところ。 下手な言い方になるがその時間で本来やりたいことをどのLLMでも良いから進めた方がよいと直感的に思う。
以上